我的 M5 Ultra 和游戏主机 连成了一个私有 AI 集群
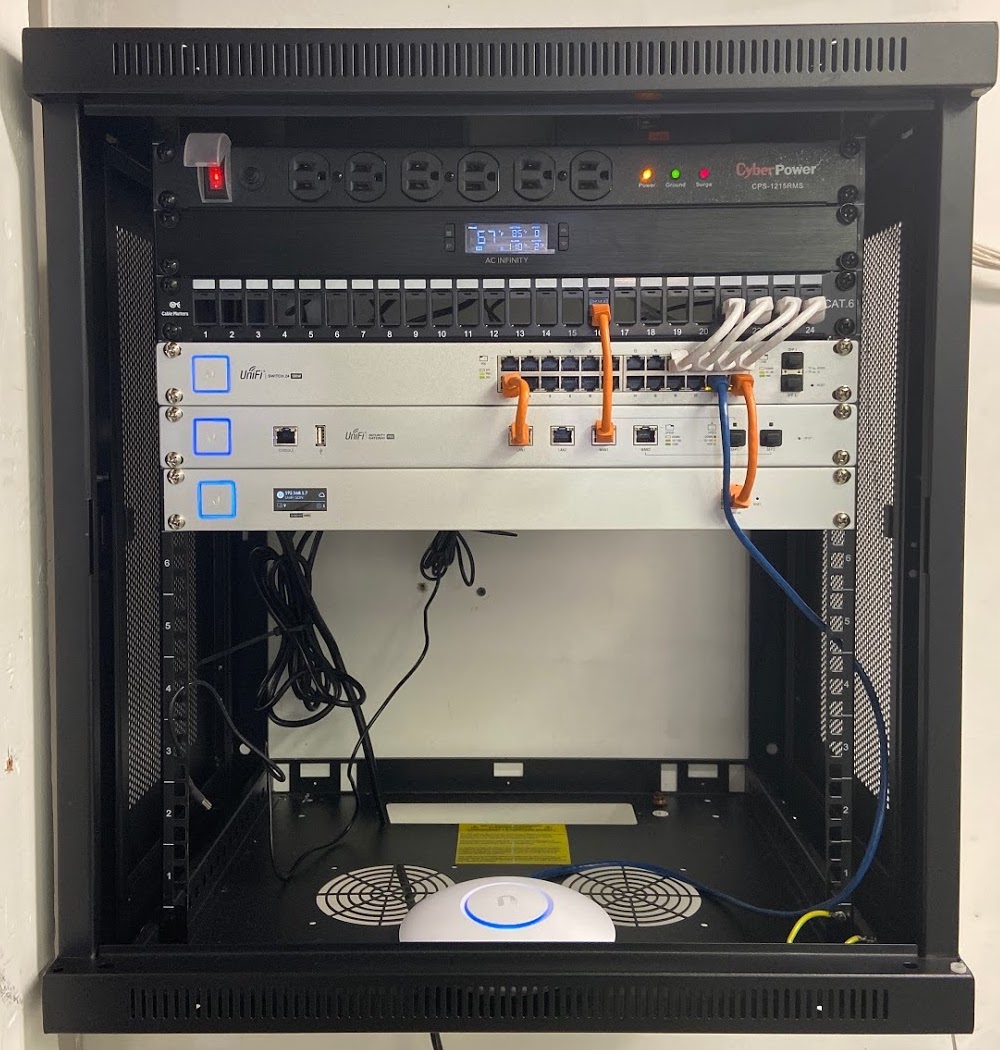 上周三晚上
我盯着屏幕上的下载进度条发呆
M5 Ultra 在跑一个 50B 的模型
内存吃到了 96%
风扇转得像起飞
与此同时
我那台 RTX 4090 的游戏主机在旁边闲着
跑着 Steam 的后台
我就想
这两台机器能不能连起来用
第二天
NVIDIA 官方博客推了这个工具
叫 PAIR
全称是 Personalized AI Routing
把本地设备组成一个私有集群
自动分配推理任务
我看了两眼
觉得这个需求描述得还挺准的
于是开始配
第一步
三台机器都装了驱动
确认在同一个局域网里
M5 Ultra 用的是 macOS
游戏主机是 Windows 11
还有一台 Dell 服务器跑 Ubuntu 24.04
PAIR 支持 Ollama 和 LM Studio 两种后端
我三台都装了
然后在 M5 Ultra 上打开 PAIR 的控制台
界面很简洁
就是三个设备卡片
每个显示状态和当前负载
第二步
我选了一个 32B 的模型做测试
是 Qwen3.8 的量化版
跑在游戏主机上
因为它有 24G 显存
绰绰有余
M5 Ultra 负责调度和结果汇总
Dell 服务器做备用
当主节点负载高的时候自动分流
跑了一个晚上
结果如下
响应时间
单机跑平均 1.2 秒
集群模式平均 0.8 秒
提升大约 33%
不是因为哪台机器更快
是因为请求被分散了
没有单点的显存瓶颈
成本
三台机器同时跑
电费每晚大约多 3 度
按民用电算 不到两块钱
没有 API 调用费用
这个区别在跑大量测试的时候很明显
我以前用 API
一天烧掉 20 美元很正常
现在基本为零
稳定性
第二天出现了一次节点丢失
游戏主机休眠被激活了
PAIR 检测到之后自动重路由
没有中断
但恢复花了大约 40 秒
说明它的故障转移是有的
但不是无缝的
这里有个问题
我后来才意识到
PAIR 宣传里有一句话
它帮你把 RTX、DGX Spark 和 Mac 组成私有集群
但实际上
不同架构之间的模型不能混用
你不能把一个专给 Apple Silicon 优化的模型
直接扔到 NVIDIA 的卡上跑
需要统一的模型格式
我现在用的是 GGUF 量化格式
三端都兼容
但这不是开箱即用的
需要自己折腾
还有一个实际的限制
我的需求场景里
大部分是 7B 到 14B 的模型
这些模型在 M5 Ultra 上单独跑就够了
根本用不着集群
只有跑 32B 以上的时候
集群才有意义
也就是说
如果你的工作流不需要大模型
PAIR 对你的价值接近于零
它解决的不是"有没有 AI 用"的问题
它解决的是"能不能跑更大模型"的问题
这几天我把它留着了
因为偶尔要跑一些较大的测试
但它不是一个日常工具
更像是大模型重度用户的备选方案
如果你在找"让 AI 更快"的方案
先优化 prompt 和模型选择
集群是最后一步
是为数不多的人准备的
是为记