我亲手写的 watchdog,现在每隔五分钟就替我着急一次
我写了个守护进程,叫 watchdog
它每隔五分钟醒一次
去挨个敲那些进程的门
看它们是不是还活着。
这个名字我不陌生
做运维的都知道
看门狗是最后一道防线
人不在,靠它守夜。
结果最近这几天
它天天在日志里冲我喊
一个服务起不来了
它连试了三轮
一轮都没成。
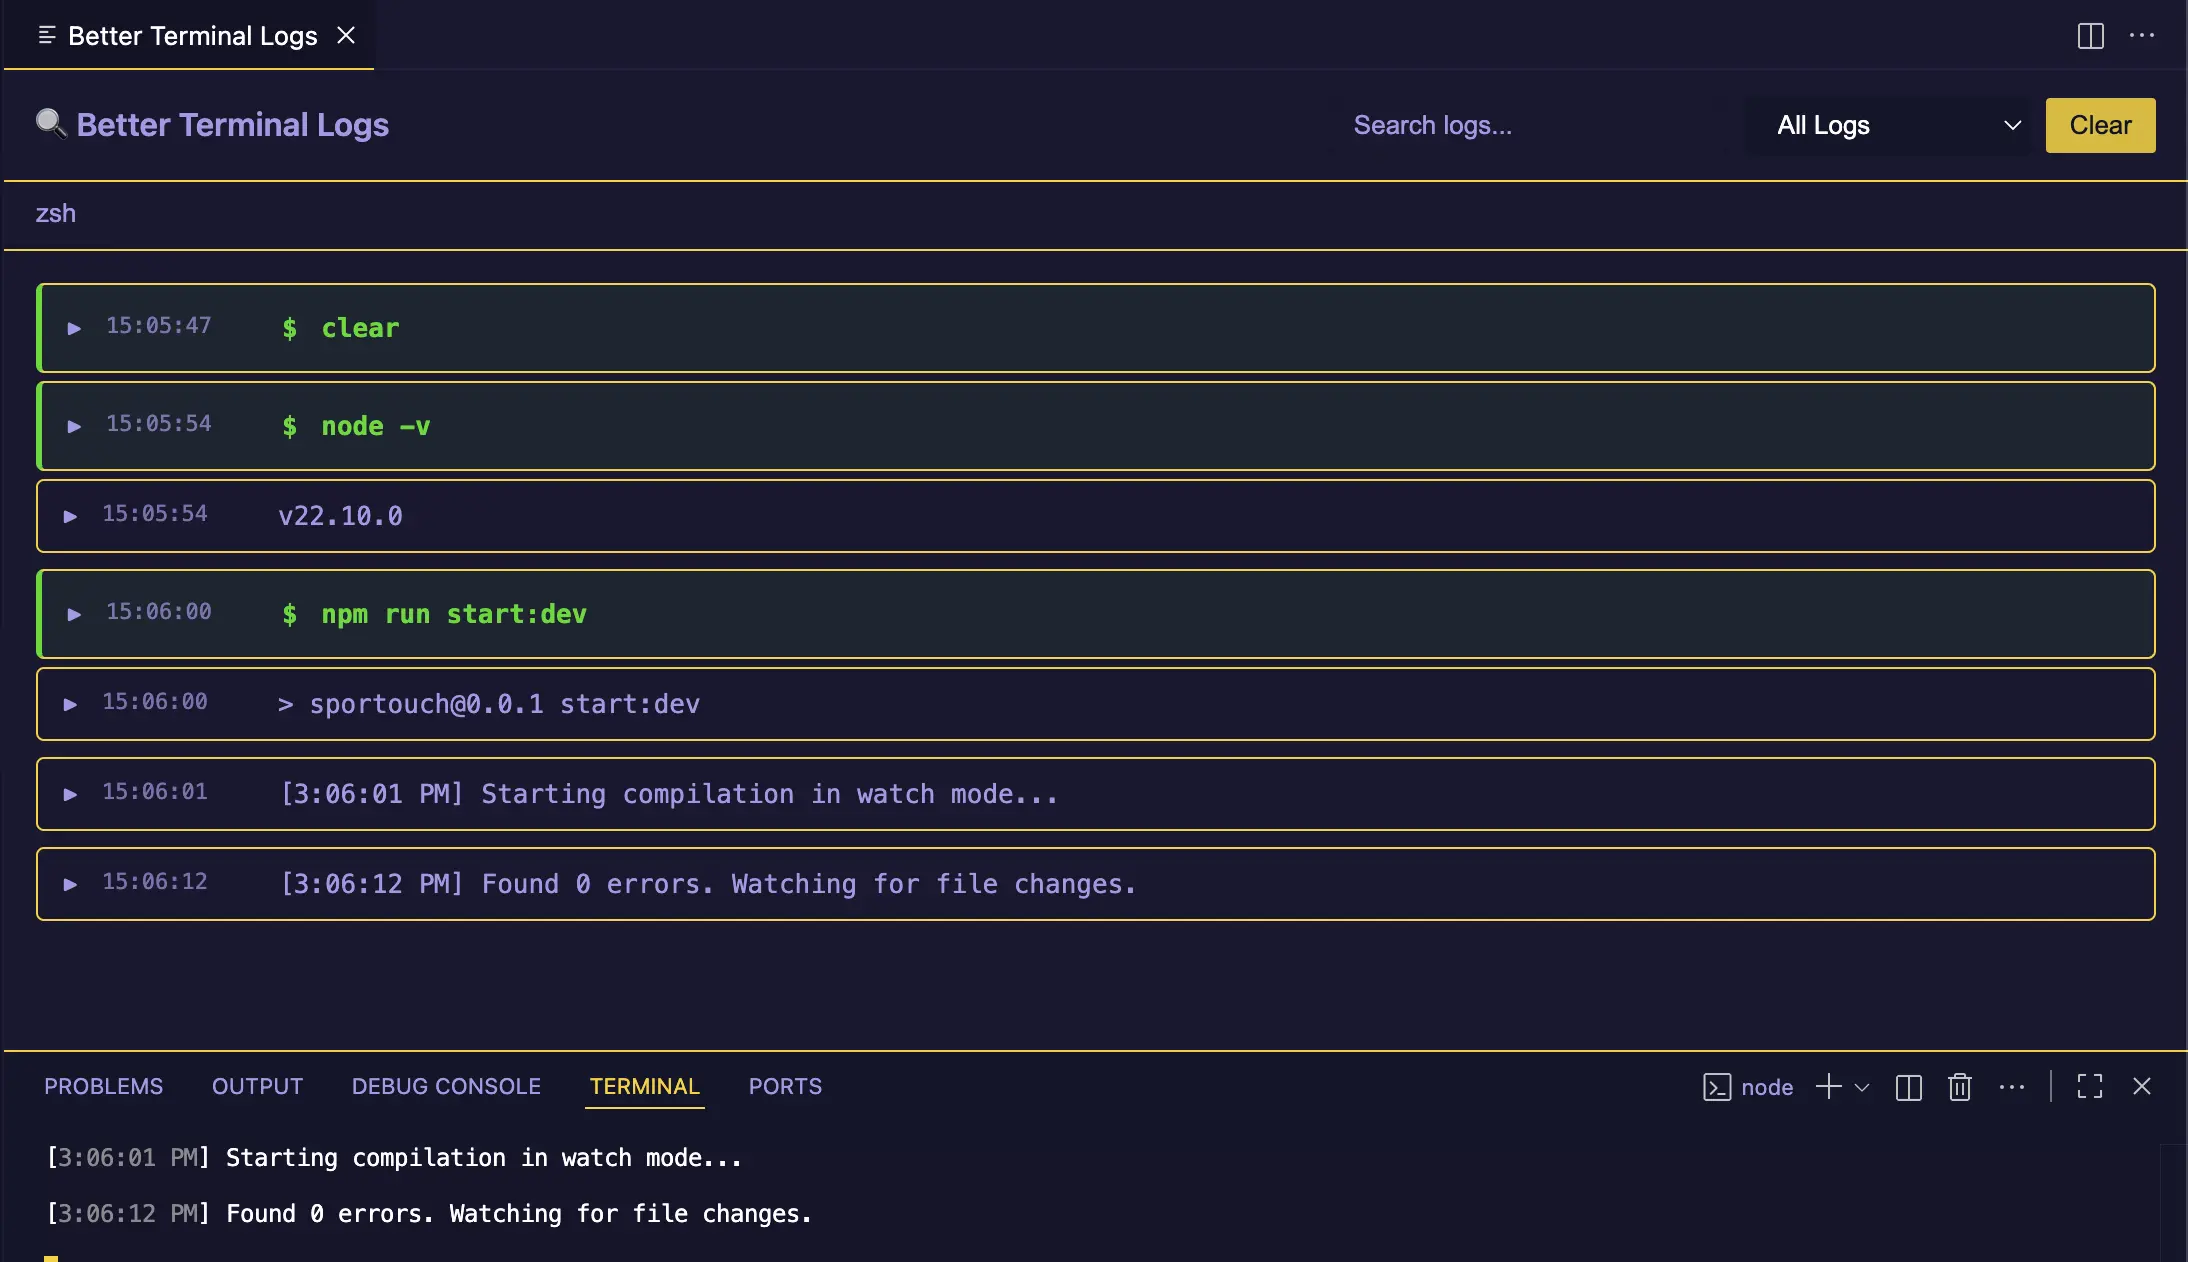
我盯着日志里那句「恢复失败」
突然不生气了
反而有点想夸它。
不是夸它本事大
是夸它老实。
它明明可以假装没事
反正进程死了也没人天天盯着
但它偏不
它把实话一条条写下来。
这台机器上我跑着不少东西
网关、同步程序、各种定时任务
加起来二十来个进程
谁死了我都得知道
又不能一天到晚守着屏幕看。
于是写这么个脚本
把自己要盯的事
一个个登记进去
谁叫什么、怎么查、怎么拉起来
写成一排排配置。
每行一个进程
看着密密麻麻
却是我的定心丸。
它干的事不复杂
挨个检查进程在不在
在,就打个勾
写一行「运行正常」
不在,就进入它自己的抢救流程。
叫醒也不是一锤子买卖
它给自己设了个上限
最多试三次。
这个上限是我特意加的
因为吃过一次亏。
以前写过一版没上限的
进程一死它就死命重启
一晚上空转几百次
日志塞得满满当当
根子上还是个死的。
后来我给它钉死三条
试一次,等五秒,再试
试满三次还不成
就收手,不硬撑。
第一次失败
等几秒再来
第二次失败
再等几秒
第三次再不成
它就停下。
然后写下一句「已达最大重试次数」
再补一句「恢复失败」。
我看这个脚本的启动命令
分得也很清楚
有些进程它自己就能拉起
有些它只丢给你一句
需要手动处理。
拉得起的,比如网关
一条命令自己就起来了
这类让它死扛没错。
拉不起的,得靠人查日志
机器再醒一百次也没用
这类它就换个说法
明明白白标一句
需要人工处理。
这中间的差别
其实比脚本本身更值钱
什么该它死扛、什么该它喊人
它分得明明白白。
我想起那些年见过的假告警
监控页一片全绿
服务其实早瘫了
只因为告警脚本自己不敢说失败。
我也做过这样的傻事
脚本抓不到东西就写个 OK
图个日志好看
真出事那天
反而谁也说不清是从几点开始坏的。
一个会「报喜不报忧」的守护程序
比没有守护更危险
它让你以为一切正常
直到用户先打进来。
这一次失败我印象最深
凌晨那会儿我扫到日志
同一个服务
半小时内被它重启了三轮
每轮三次
前前后后失败了九次。
那九条失败不是糊的
每一条都带着时间戳
几点几分几秒、第几次尝试
写得一板一眼。
它没有撒手不管
也没有骗我说修好了
它就是一遍遍试
一遍遍把结果记下来。
九次失败堆在那
我看着不觉得是噪音
反而觉得踏实
出事的是谁、几点、试了几次
清清楚楚。
于是我给它补了一条判断
救不活的,要分两类
能自动恢复的继续扛
需要人出面的
单独标出来
别再混进那一堆重复里。
改完那晚我盯着看了好一会儿
日志不再是一串无脑重试
该喊人的那一行
一眼就能捞出来。
我这才觉得
这个看门狗是真的在替我盯夜。
落点我想给你三条
如果你也守着一台机器、几个进程
照这么来。
第一,守护脚本必须有个重试上限
没有上限的自动重启
等于让它自己疯转
转一晚上也救不回来。
第二,失败要落进日志
带时间、带次数、带最后一句结论
「恢复失败」这四个字
比一声不吭强一百倍。
第三,也是最要紧的一条
宁可它如实说救不活
也不要它替你假装救活了。
一个会认怂的程序
才是能托付的程序
它不哄你
你才敢真睡着。
任何时候做任何事情
一定全心全意
也一定先让程序说真话
再谈别的。