看懂诊断缓冲区这几条,一半的"随机停机"当场能定位
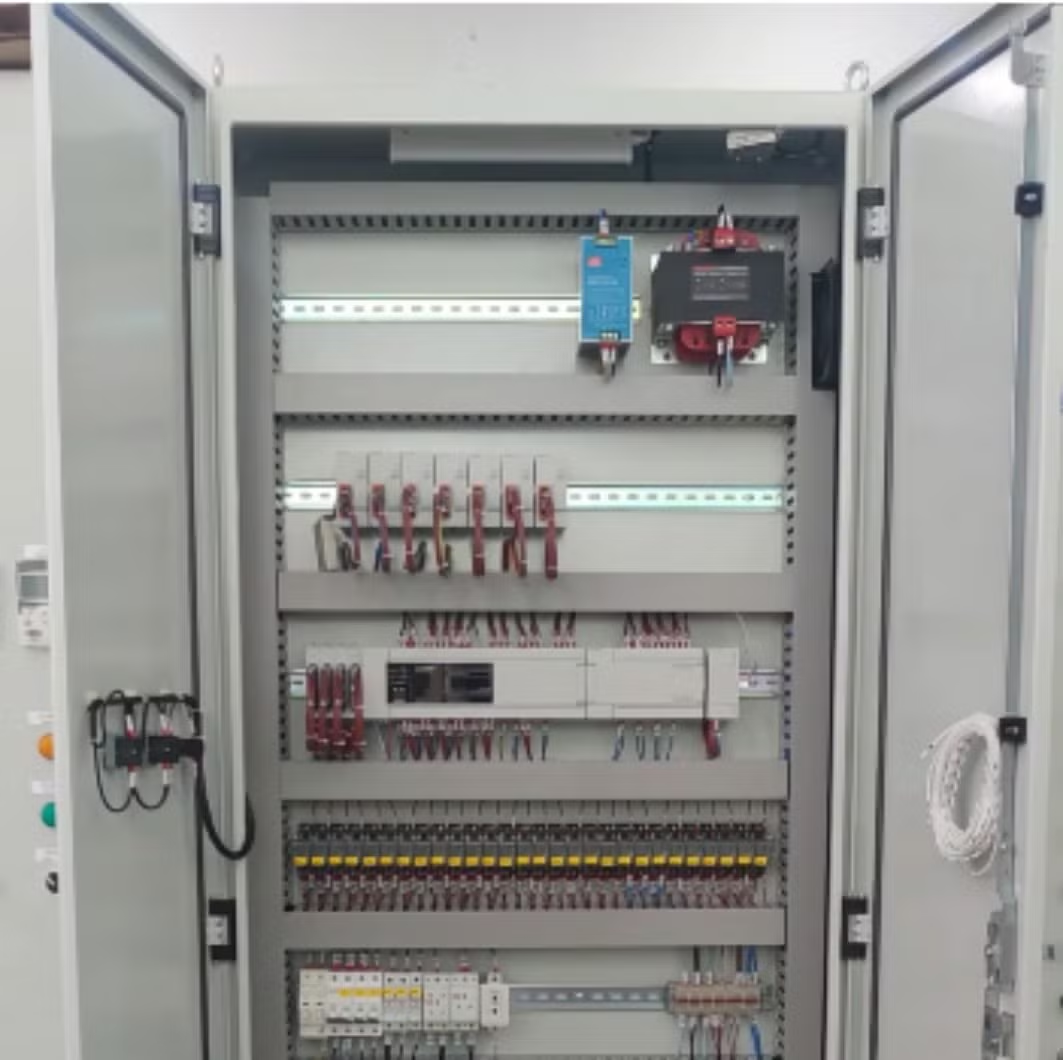
一台 S7-1200 的灌装线,一个月停了三次 三次都不在同一个时间 现场的处理方式都一样:断电,重启,好了 没人知道为什么好,也没人记录到底发生了什么。下个月,它又停。
其实 CPU 都替你记着 博图连上去,打开"诊断缓冲区" 每次停机的时间、事件、当时的错误,一条条列在那里 多数现场的问题不是没有答案,是没人去翻这份记录。
诊断缓冲区是什么、存在哪
它是 CPU 装载存储器里的一段循环记录区 S7-1200 / S7-1500 会把掉电、IO 故障、通信中断、程序错误这些事件按时间写进去 写满了就滚掉旧的,留新的 所以它只回答"最近发生了什么",不回答"三个月前那次是什么"。
看它的顺序也有讲究 先看时间戳,对着停机时刻找 再看事件前后的几条 故障往往不是孤立的——先有一条 IO 访问错误,几秒后才是停机。
最后才看代码本身 这一类报警通常指向什么,下面这张表说清楚 具体到某个报警号的准确定义,以博图帮助和诊断缓冲区原文为准 别凭记忆下结论,也别拿网上一段摘抄就动设备。
5 类高频诊断事件速查表
| 诊断事件 | 通常指向 | 常见原因(按概率排) | 动手前先做 |
|---|---|---|---|
| IO 访问错误 | 程序在读一个不存在的模块或通道 | 模块损坏或松脱;组态里的订货号和实际硬件对不上;接线端子松动 | 先别动程序,确认机架上模块在不在、组态和实物是否一致 |
| 通信故障(PROFINET) | 某个设备的连接断过 | 网线或水晶头老化;交换机端口问题;设备名或 IP 冲突 | 记下是哪个设备断的、断了几次,再看是单点还是整网 |
| 时间错误 / 循环时间超限 | 程序跑一个周期的时间超过了设定值 | 程序里新增了重循环或阻塞调用;对应的 OB 未下载导致停机 | 对比报错前后改过什么程序,别急着加长监控时间 |
| 掉电 / 热启动记录 | CPU 断过电 | 供电回路接触不良;上游空开跳;真停电 | 看断电时刻和现场作业时间是否吻合,很多"随机"断电其实是人为 |
| 写保护 / 程序错误类事件 | 程序访问了不该访问的地址 | 间接寻址越界;未初始化的变量被当成指针用 | 记下事件发生时的工况,这类通常要带着程序才能定位 |
这张表建议存到手机 定位不了细节没关系 能把"哪类事件、几点几分、断的是哪个设备"说清楚,已经比"它自己停了"值钱得多。
举一个我们碰到过的过程
早上一台设备的缓冲区里有这样一串记录 8:02,IO 访问错误,指向某个输出模块的一个通道 8:02 同一秒,对应的通信记录跟着出现 8:03,程序触发停机 现场先把模块重新插紧,故障当天没再出现——但一周后同样的事件又来了 后来查出是柜门开合时线槽蹭到了端子,线皮磨破 不动程序,只处理了接线,这件事才算完 时间对得上、动作对得上,原因才站得住 如果当时直接重下程序,这两次白排查,后面还会第三次停机。
现场常踩的三个坑
坑一:报警一弹就重启 重启只是把证据擦了 缓冲区滚掉一轮,前因后果就没了 正确顺序是:先在线读缓冲区,导出或截图,再复位。
坑二:只看末尾一条 多数停机是连锁反应 IO 访问错误在前,通信超时在后,停机在最后 只看末尾那条,排查方向就反了。
坑三:导出的记录没人存档 缓冲区是循环的,被新记录盖掉就找不回来 导出的文件建议和设备档案放在一起,按日期命名 下次同类故障,翻旧记录比重新排查快。
什么时候这事不值得做
设备一年停不了一次,症状明确是硬件坏,换了模块就好——不用折腾缓冲区,直接换 备份完整、厂家响应快的老设备,也犯不着自己排查,打电话比读记录快 诊断缓冲区解决的是"反复停机、原因不明、每次重启又好"这类问题 如果你的设备不属于这类,这篇看看就行。
一句实在话:公司是新的,但团队在电气与软件这两行做了三十多年 诊断缓冲区这种东西,价值不在技术多深,在于有人肯一条条读 设备软件的事,读不懂的记录可以发给我们看——能做的说能做,做不了的我们说清楚。
更多这类速查表,我们会持续整理。